

想象一下,在一个老旧托管机房中有一套传统机架,风冷功率为 8 kW,而计划是把它改造成一套承载四台 NVIDIA H100 服务器的 40 kW 直接芯片级液冷机架。机架是最小的基础设施单元,但升级它会影响周围的一切。
本文沿一条运算链条展开:从 40 kW 机架产生的热量,到它所需的加仑水量、电流安培数、地板承重公斤数和网络端口数。每个答案都作为下一个问题的输入,每一个都决定这台机架是否有资格成为 AI就绪数据中心 的一部分。只有整条链条结算完成后,AI就绪数据中心 这样的标签才具有可测量的意义。这个推演刻意设定得很小,只有一台机架和四台服务器,却能解答一个关乎整栋建筑的问题。
为什么 40 kW 升级要从热量而非电力说起?
电力和热量是同一个数字,因为服务器消耗的每一瓦都必须以热量的形式排出。一台 40 kW 机架产生 136,500 BTU/h 的热量,因为每千瓦大约相当于 3,412 BTU/h,约合 11.4 制冷吨。相比之下,一台 8 kW 风冷机架仅产生 27,300 BTU/h,即 2.3 制冷吨。5 倍的跃升决定了后续每一根管道、每一条电路和每一块地板的尺寸。
在这个数字确定之前,后续任何计算都没有意义,这就是为什么以机架为边界的 AI就绪数据中心 升级,第一步审计是建立热量台账,而不是电力预算。简而言之,AI就绪数据中心 首先是一份热量声明,所有工程决策都位于它之后。无论机架里是四台 H100 还是八块较小的 GPU,这套数学都成立;变化的只是热量台账。
AI就绪数据中心的机架需要多少冷却液流量?
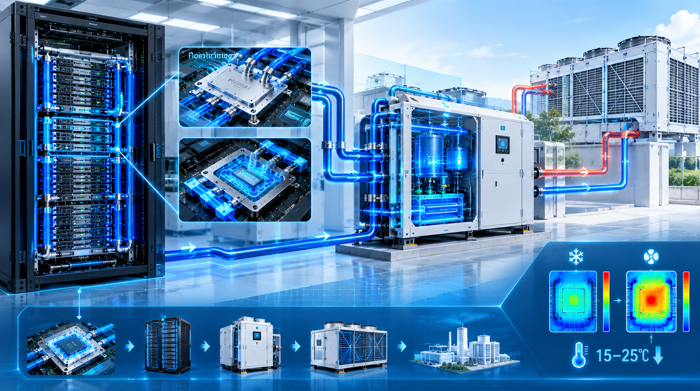
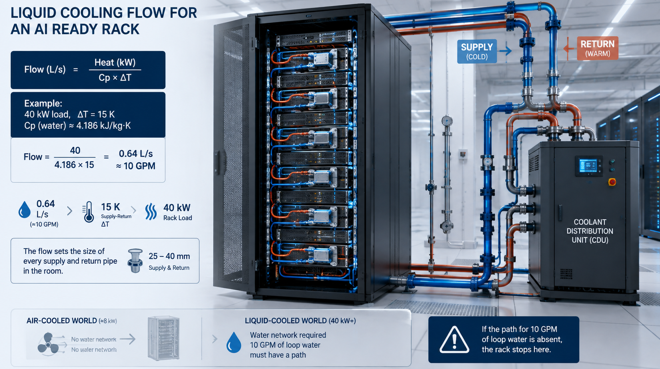
液冷之所以存在,是因为空气无法将 40 kW 的热量从狭小空间内带走。流量遵循一个简单的公式:热量除以水的比热容和温升。按常见的 15 K 供回水温差计算,40 kW 负载大约需要 0.64 L/s 的流量,约合每分钟 10 加仑。这些水量通过一根 25–40 mm 的供回水管路,流向冷却液分配单元。这些数字看起来很小,但它们决定了机房内每一根供回水管路的管径,这正是 AI就绪数据中心 在管道层面的定义。
在 8 kW 风冷的世界里,根本没有水网,因此大多数机房都会忽略的问题在于:这些管路是否存在,以及它们能从哪里走。如果没有容纳 10 GPM 循环水的路径,这台机架就会止步于此,无论机房在纸面上宣称多大的功率。这就是为什么真正的 AI就绪数据中心 始于管道,而不是始于服务器。
AI就绪数据中心的机架需要多大的电力回路?
这个热量数字如今换算成电流,而大多数老旧配电柜都无法承受这份电流需求。在 415V 三相供电、0.9 功率因数下,一台 40 kW 机架大约需要 62 A 电流。而在老旧建筑中常见的 208V 三相系统下,同一台机架大约需要 123 A,这意味着需要专用的馈电线路和更大的断路器。62 A 和 123 A 这两个数字,就是 AI就绪数据中心 机架在两种电压下的电气指纹。
Ethernet Alliance 的 2026 年白皮书明确指出,415V 到机架现在已成为新建 AI 项目的必备条件,而大多数受 208V 限制的机房无法容纳 AI 设备。传统机架配置两台 60 A 或 63 A 的 PDU;与之相比,AI 机架需要多台 100 A 及以上的 PDU。上游的变压器和开关柜遵循同样的运算逻辑,因此大多数 208V 建筑恰恰在这个节点上、悄无声息地不再具备 AI就绪数据中心 的资格。
你的机房地板能承受 AI就绪数据中心 机架的重量吗?
一台 40 kW 机架不仅热,而且重。四台 H100 服务器本身重约 560 kg,再加上机架、线缆和冷却硬件,一台液冷机组的重量接近 800–900 kg。按标准的 0.6 米 × 1.2 米占地计算,大约相当于 1,100 kg/平方米。传统架空地板设计通常额定承重为 450–600 kg/平方米,其点荷载远低于高密度 GPU 机架实际施加的荷载。在 AI就绪数据中心 改造中,真正构成约束的往往是结构,而不是服务器。
选择改造的运营方常常发现,结构加固的成本高于冷却系统本身。这是整条链条中第一个财务性而非物理性的环节,它也常常让那些通过了水和电两项检查的升级方案就此夭折。地板若在此环节不达标,这台机架就无权宣称自己属于任何 AI就绪数据中心。
一台 AI就绪数据中心 机架会威胁周围的机架吗?
液冷机架同样要排出热量,只不过是通过水而不是机房空气,而这些热量必须有去处。如果冷却液分配单元把 30–40 kW 的热量排进同一间机房,而周围的风冷机架正在吸入空气,那么相邻服务器会吸入较热的空气并触发降频。
AFCOM 的 2025 年报告发现,只有 17% 的数据中心采用了液冷,另有 32% 计划在 12–24 个月内采用,因此混合机房是常态而非例外。这部分废热是真实存在的,因为按 80% 的冷媒到空气换热效率计算,仍有约 8 kW 的热量泄漏进机房。
工程上的答案是分区:液冷排必须通过热通道封闭和独立气流与风冷排隔离。因此,在全风冷机房中做单机架试点,绝不只是电气项目,因为这会悄悄拖累同一条通道上的每一台机架。行级分区才是 AI就绪数据中心 在实践中的含义,因为这个标签是对整栋建筑的承诺。
一台机架需要多少个 400G 端口才算是真正的 AI 节点?
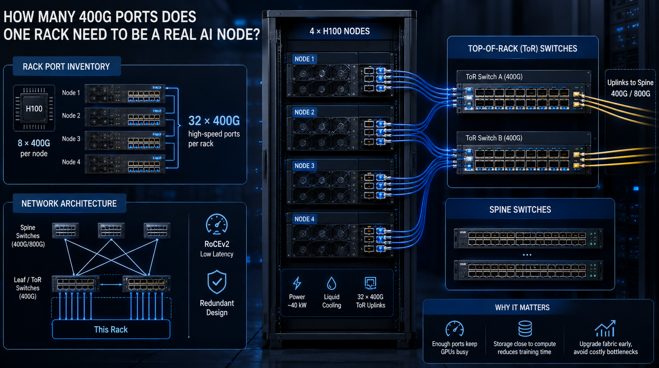
机架内的四个 H100 节点各带 8 个 400 Gb/s 端口,因此整台机架共暴露 32 个高速端口。这些端口必须接到 400G 机架顶部(ToR)交换机上,通常为一对冗余配置,上行采用 400G 或 800G。Cisco 的 AI 基础设施指南描述的正是这种模式:高基数叶脊(leaf-spine)拓扑,以及用于集合通信的 RoCEv2。没有这份端口清单,任何软件栈都无法把这台机架当作真正的 AI就绪数据中心 节点。
存储必须紧挨计算资源,因为检查点写入和数据加载占据了训练时间的大头。一台电力、冷却都充足但网络饱和的机架,是没法用于训练的。网络邻近度与冷却一样,都是 AI就绪数据中心 的属性,因为时延决定了 GPU 能否始终保持忙碌。预先升级网络结构所付出的代价,远低于训练开始后才暴露瓶颈的代价。
单机架升级实际要花多少钱,值不值得?
前面这些数字加总之后,就能解释为什么”改造”这个词让大多数运营方望而生畏。施耐德电气(Schneider Electric)和 Omdia 的分析师指出,改造老旧设施极具挑战性,因为其馈电、冷却和结构都是为 20 世纪的负载而建,而非为 GPU 集群而建。他们得出的结论是,对许多企业而言,专门新建的托管(colocation)在经济上更具优势,这也使得 AI就绪数据中心 这个标签在就地改造场景中极难赢得。
此外,改造的成本会随每一个缺失的门槛而增长,因为每一项缺口都要付出双倍的代价:既要花钱去绕开它做工程设计,又要为损失的产能买单。
单机架试点仍然可行,但它的真正价值在于测量,而不是生产。这次升级会揭示出该建筑中最硬的约束是哪个门槛:热量、水、电流、结构还是网络。这些证据让你的团队能做出抉择:是在一台经优化整合的机架基础上继续扩展,还是迁往专门新建的场地。它同时也逼着运营团队直面这些问题:谁负责管理和监控这条水路?当一根 10 GPM 的管道在价值 20 万美元的 GPU 机架上方泄漏时,会发生什么?
承包商、基础设施团队和网络人员必须在第一台服务器启动之前达成一致,而这个答案会告诉你,这栋建筑究竟有没有可能承载一个 AI就绪数据中心。
审计机架是否达到 AI就绪数据中心 状态的正确顺序是什么?
现在,这条链条收敛为一份有序的检查清单。
- 第一,把热量数字锁定在 40 kW。
- 第二,按约 10 GPM 配液循环,并核实实际存在的管路路径。
- 第三,确认 415V 下约 62 A 的专用回路,或规划馈电工程。第四,核对地板是否足以承载 800–900 kg 的机架和 1,100 kg/平方米的荷载。
- 第五,将机架与风冷邻居隔离。
- 第六,为 32 个 400G 端口和邻近存储预留预算。
- 第七,将试点方案与托管方案做成本对比。
顺序很重要,因为任何一个环节的失败,都会使其后的所有环节失效。一台通过全部七项检查的机架,仍然只是一台机架,但它是 AI就绪数据中心 的第一个真实单位——可测量、有记录、可以逐架复制。