

2–3 anos para construir
Data centers tradicionais levam de 24 a 36 meses do planejamento ao comissionamento. Quando sua instalação estiver pronta, a arquitetura de GPU já estará uma geração atrás.

O desafio
A revolução das GPUs superou o design tradicional de data centers. As GPUs H100 e B200 exigem densidades de potência que rompem os limites do resfriamento convencional — e prazos de construção que não acompanham a velocidade da inovação em AI.
2–3 anos para construir
Data centers tradicionais levam de 24 a 36 meses do planejamento ao comissionamento. Quando sua instalação estiver pronta, a arquitetura de GPU já estará uma geração atrás.
25 kW — limite do ar
Acima de 25kW por rack, o resfriamento a ar forçado simplesmente não remove calor rápido o suficiente. Clusters NVIDIA H100 passam de 40kW com frequência — e o B200 ultrapassa 100kW. Resfriamento a ar não é mais uma opção.
$50M+ de capital antes da primeira GPU
A construção convencional exige capital inicial massivo — aquisição de terreno, licenças, obras civis, infraestrutura MEP — tudo antes de instalar um único servidor. Isso adia o ROI e prende capital por anos.
A plataforma
Uma plataforma integrada que entrega o data center de AI completo — térmica, energia, estrutura e controle — construída em torno da sua carga de trabalho de GPU.
Cada data center de AI da SOETECK é construído em fábrica dentro de contêineres marítimos ISO padrão. 95% pré-montado, testado em nossa fábrica e enviado para todo o mundo. Conecte energia, rede e água — a computação começa.
A tecnologia de cold plates direto ao chip remove o calor na fonte. Unidades de Distribuição de Refrigerante (CDU) integradas suportam até 1.5MW de carga térmica por módulo. PUE tão baixo quanto 1.08.
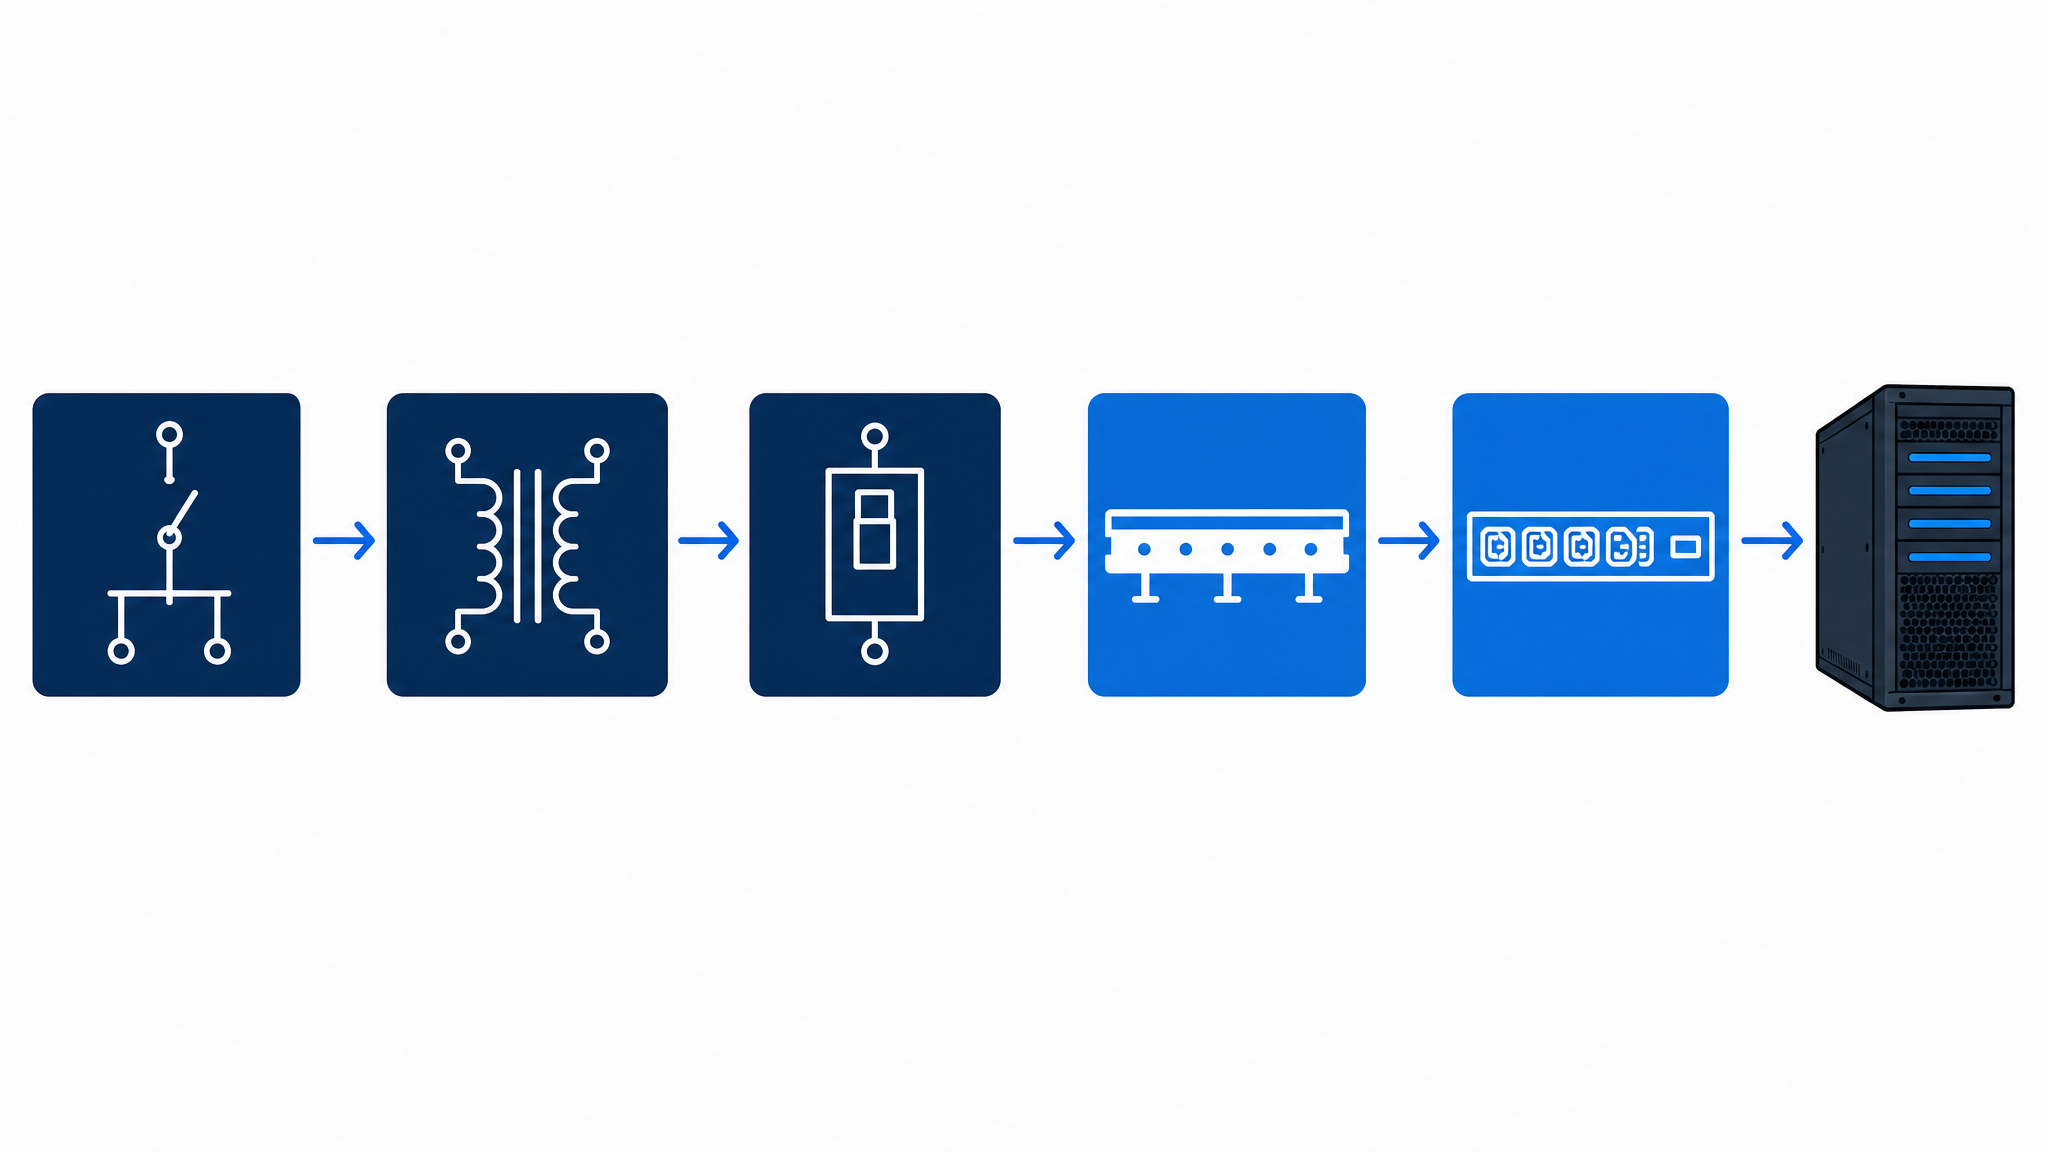
De quadros de média tensão a PDUs de rack inteligentes — projetado para 40–120kW por rack. UPS modulares de Li-Ion, busway de 800A, medição por tomada.
Sem vendor lock-in. Suporte total a NVIDIA H100/H200/B200, AMD MI300X, Huawei Ascend 910B/C e Intel Gaudi. Escolha a GPU que atenda sua carga de trabalho e seu orçamento.
Uma única plataforma de infraestrutura de AI que escala da inferência de borda aos clusters hiperscale.
| Especificação | AI-Edge | AI-Core | AI-Flex |
|---|---|---|---|
| Contêiner | 20ft ISO padrão | 40ft High-Cube ISO padrão | 4–20+ módulos 40ft interconectados |
| Potência | 80–200 kW | 300–600 kW | 2–20 MW |
| Capacidade de GPU | 8–16 GPUs | 32–64 GPUs | 256–2048+ GPUs |
| Refrigeração | Resfriado a ar padrão, líquido opcional | Líquido direto ao chip com CDU integrado | Líquido centralizado + imersão opcional |
| Densidade por rack | Até 30 kW | Até 100 kW | Até 120 kW |
| PUE | 1.15–1.25 | 1.08–1.15 | < 1.10 (1.03 imersão) |
| Implantação | 60–90 dias | 90–120 dias | 120–180 dias |
| Ideal para | Inferência de borda, manufatura inteligente, edge 5G | Treinamento de LLM, fine-tuning, clusters de pesquisa | AI hiperscale, nuvens de AI, computação nacional |
Inferência de borda
Ideal para: Inferência de AI na borda, manufatura inteligente, edge 5G de telecom, AI no varejo
Consultar AI-Edge →Treinamento e fine-tuning
Ideal para: Treinamento de LLM corporativo, fine-tuning de modelos de AI, clusters de pesquisa universitária
Consultar AI-Core →Clusters hiperscale
Ideal para: Treinamento de AI hiperscale, provedores de nuvem de AI, centros nacionais de computação de AI
Consultar AI-Flex →Refrigeração
A física é simples: refrigerantes líquidos oferecem mais de 3000× a capacidade de remoção de calor por unidade de volume que o ar. Todo hyperscaler está migrando para a refrigeração líquida. A única questão é a velocidade.
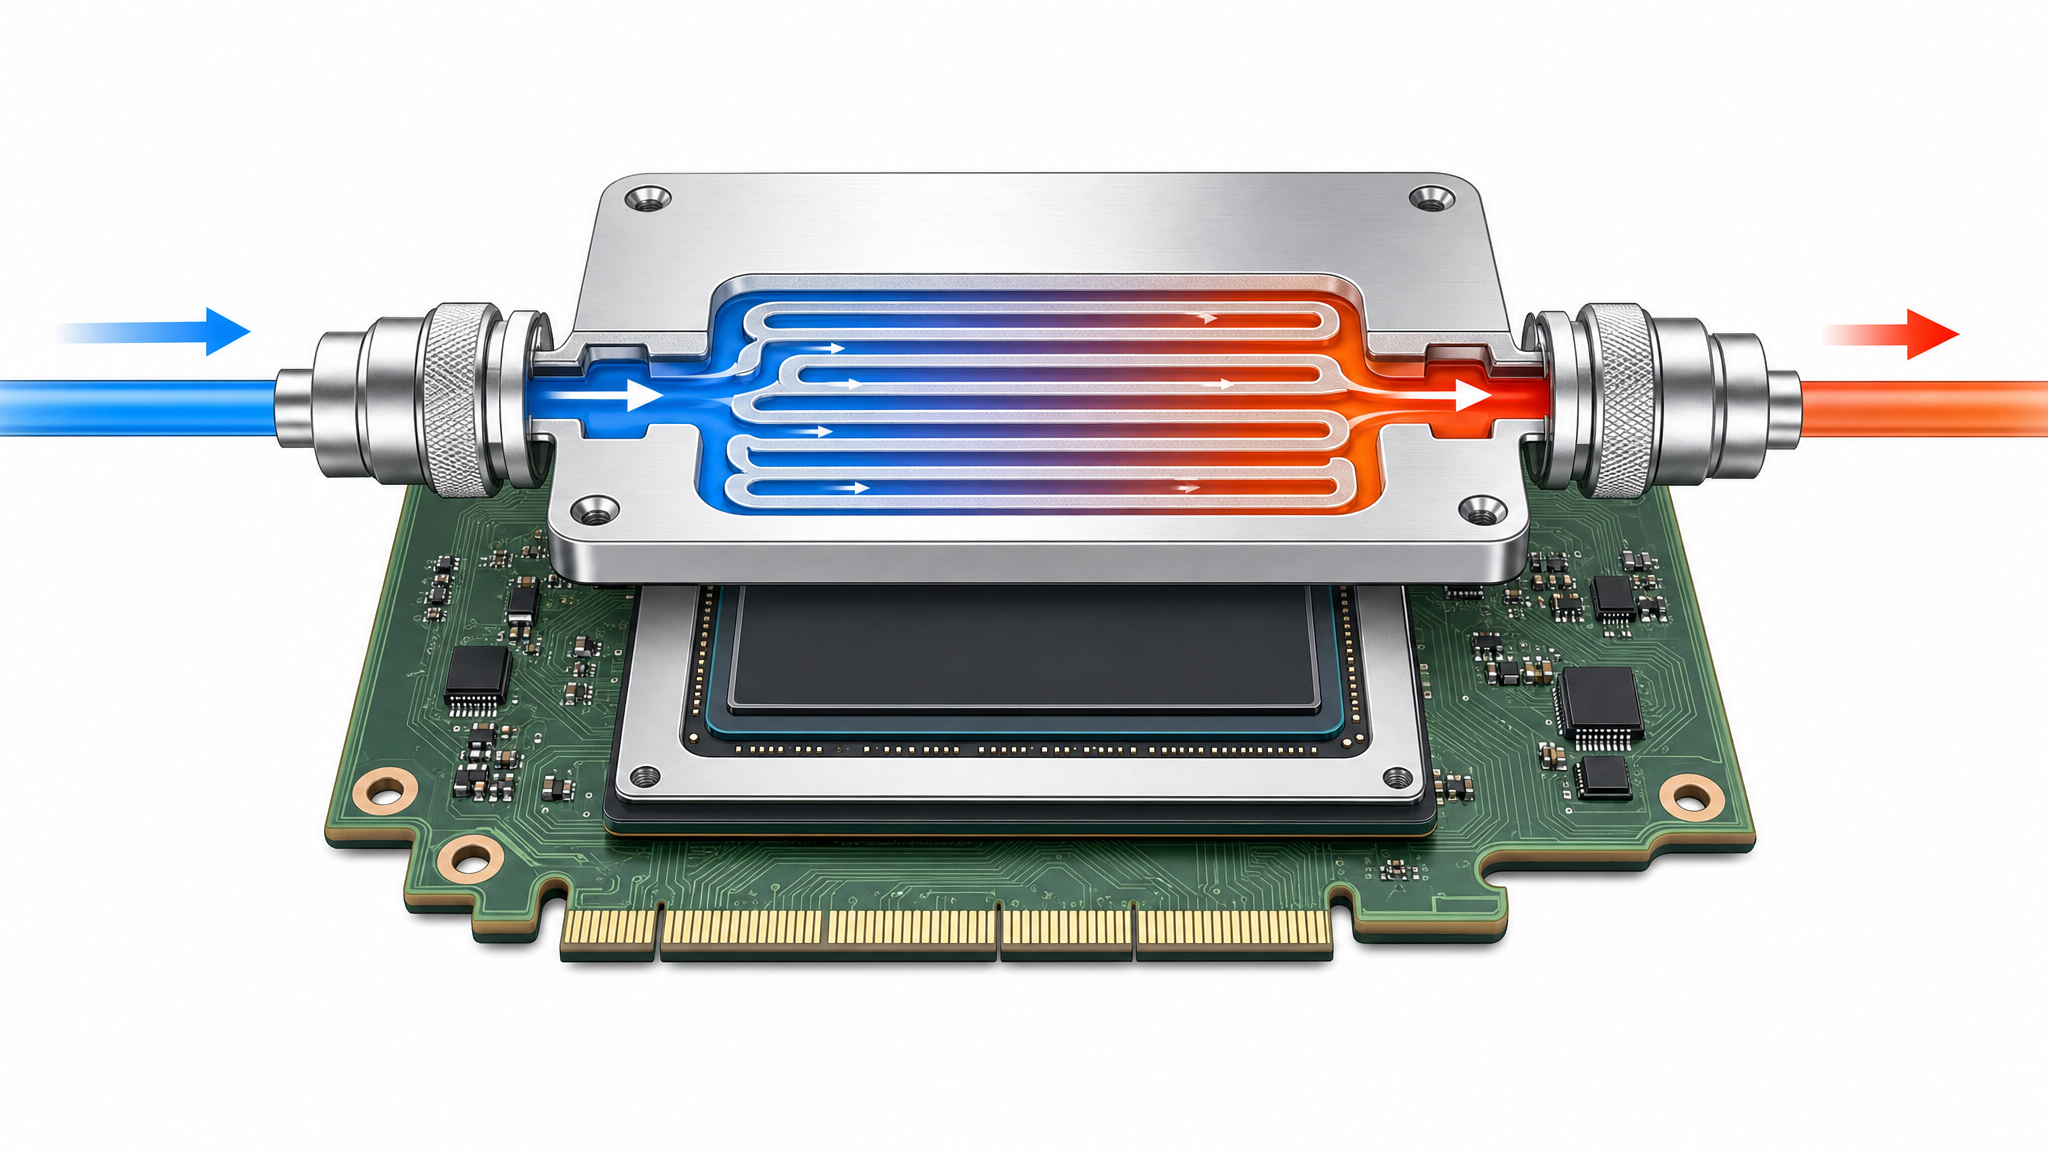
A refrigeração líquida direto ao chip é a força de trabalho da infraestrutura moderna de AI. As cold plates são montadas diretamente sobre os heat spreaders das GPUs e CPUs, circulando um refrigerante dielétrico por aletas de microcanais para remover o calor na fonte.
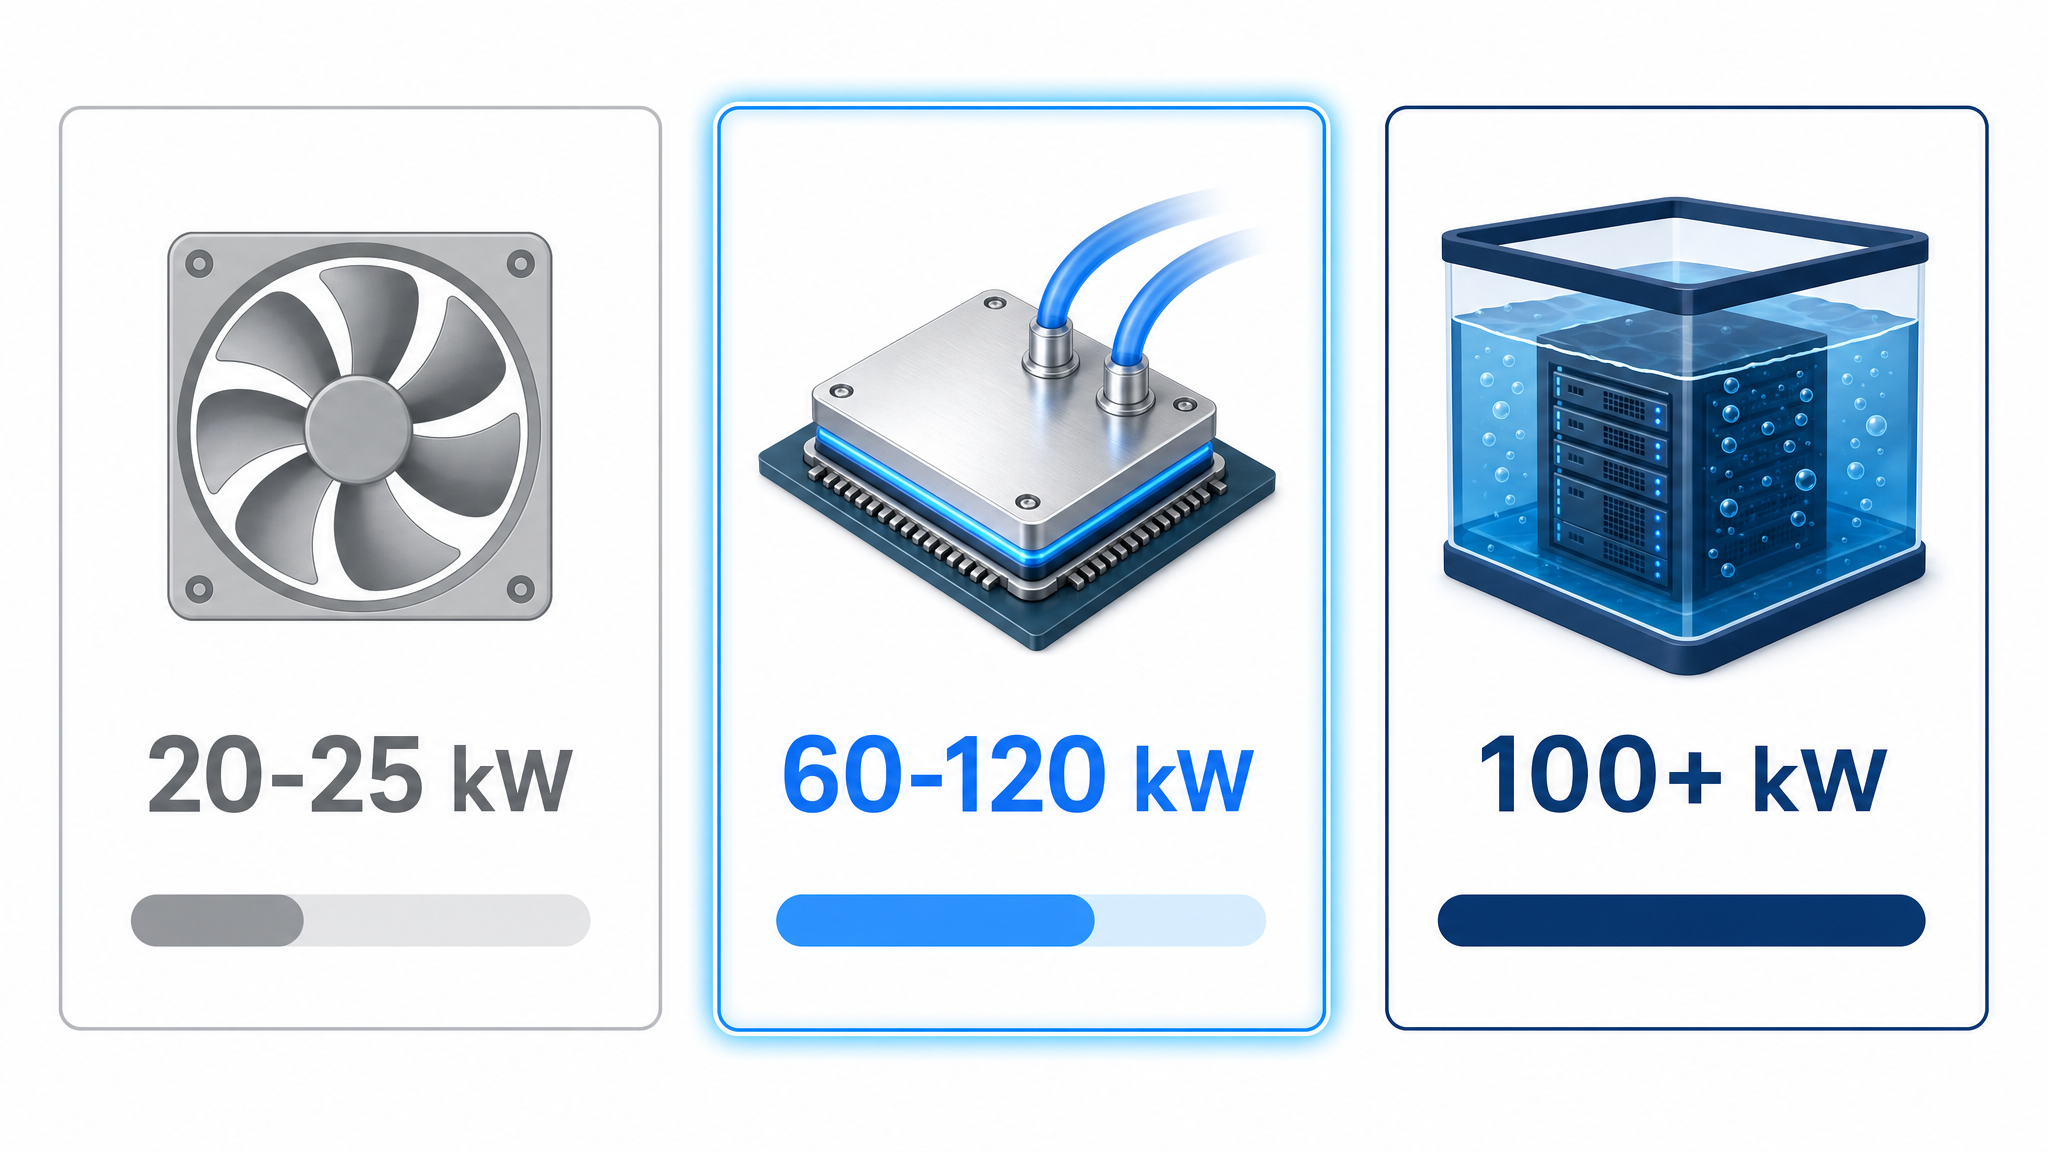
Para as implantações de maior densidade, a refrigeração por imersão monofásica submerge servidores de GPU inteiros em um fluido dielétrico que absorve calor 1200× mais eficientemente que o ar.
O ar tem capacidade térmica volumétrica de ~1.2 kJ/m³·K. Refrigerantes líquidos oferecem 3500–4200 kJ/m³·K — mais de 3000× a capacidade de remoção de calor por unidade de volume.
Energia
Clusters de GPU não precisam apenas de mais energia — precisam de energia entregue de forma diferente. Nossa cadeia integrada de distribuição de energia é projetada desde o início para cargas de trabalho de AI de alta densidade e missão crítica.
Tecnologia de baterias Li-Ion, redundância N+1 ou 2N, eficiência de 98% em modo eco. Escalável de 100kW a 2MW por módulo. Módulos de bateria com troca a quente e Sistema de Gerenciamento de Baterias (BMS) integrado.
Busway aéreo de 160A–800A com caixas de derivação a cada 600mm. Elimina a complexidade do cabeamento sob o piso. Derivações com troca a quente permitem adicionar ou realocar racks de GPU sem desligamentos.
Medição de energia por tomada (precisão de ±1%), comutação remota de tomadas, sensores ambientais integrados (temperatura, umidade, contato da porta). SNMP v3 + REST API para integração com plataformas DCIM e BMS.
Velocidade até a computação
Do pedido às GPUs operacionais em 90–120 dias, contra 24–36 meses de uma construção tradicional.
Requisitos confirmados. Seleção de GPU finalizada. Projeto de energia aprovado.
Contêiner fabricado. CDU de refrigeração integrado. Sistema completo testado em nossa fábrica.
Logística do porto ao site gerenciada. Desalfandegamento conduzido por nossos parceiros globais de frete.
Conecte energia, rede e água. Testes de aceitação. Treinamento de operadores. A computação começa.
Logística global
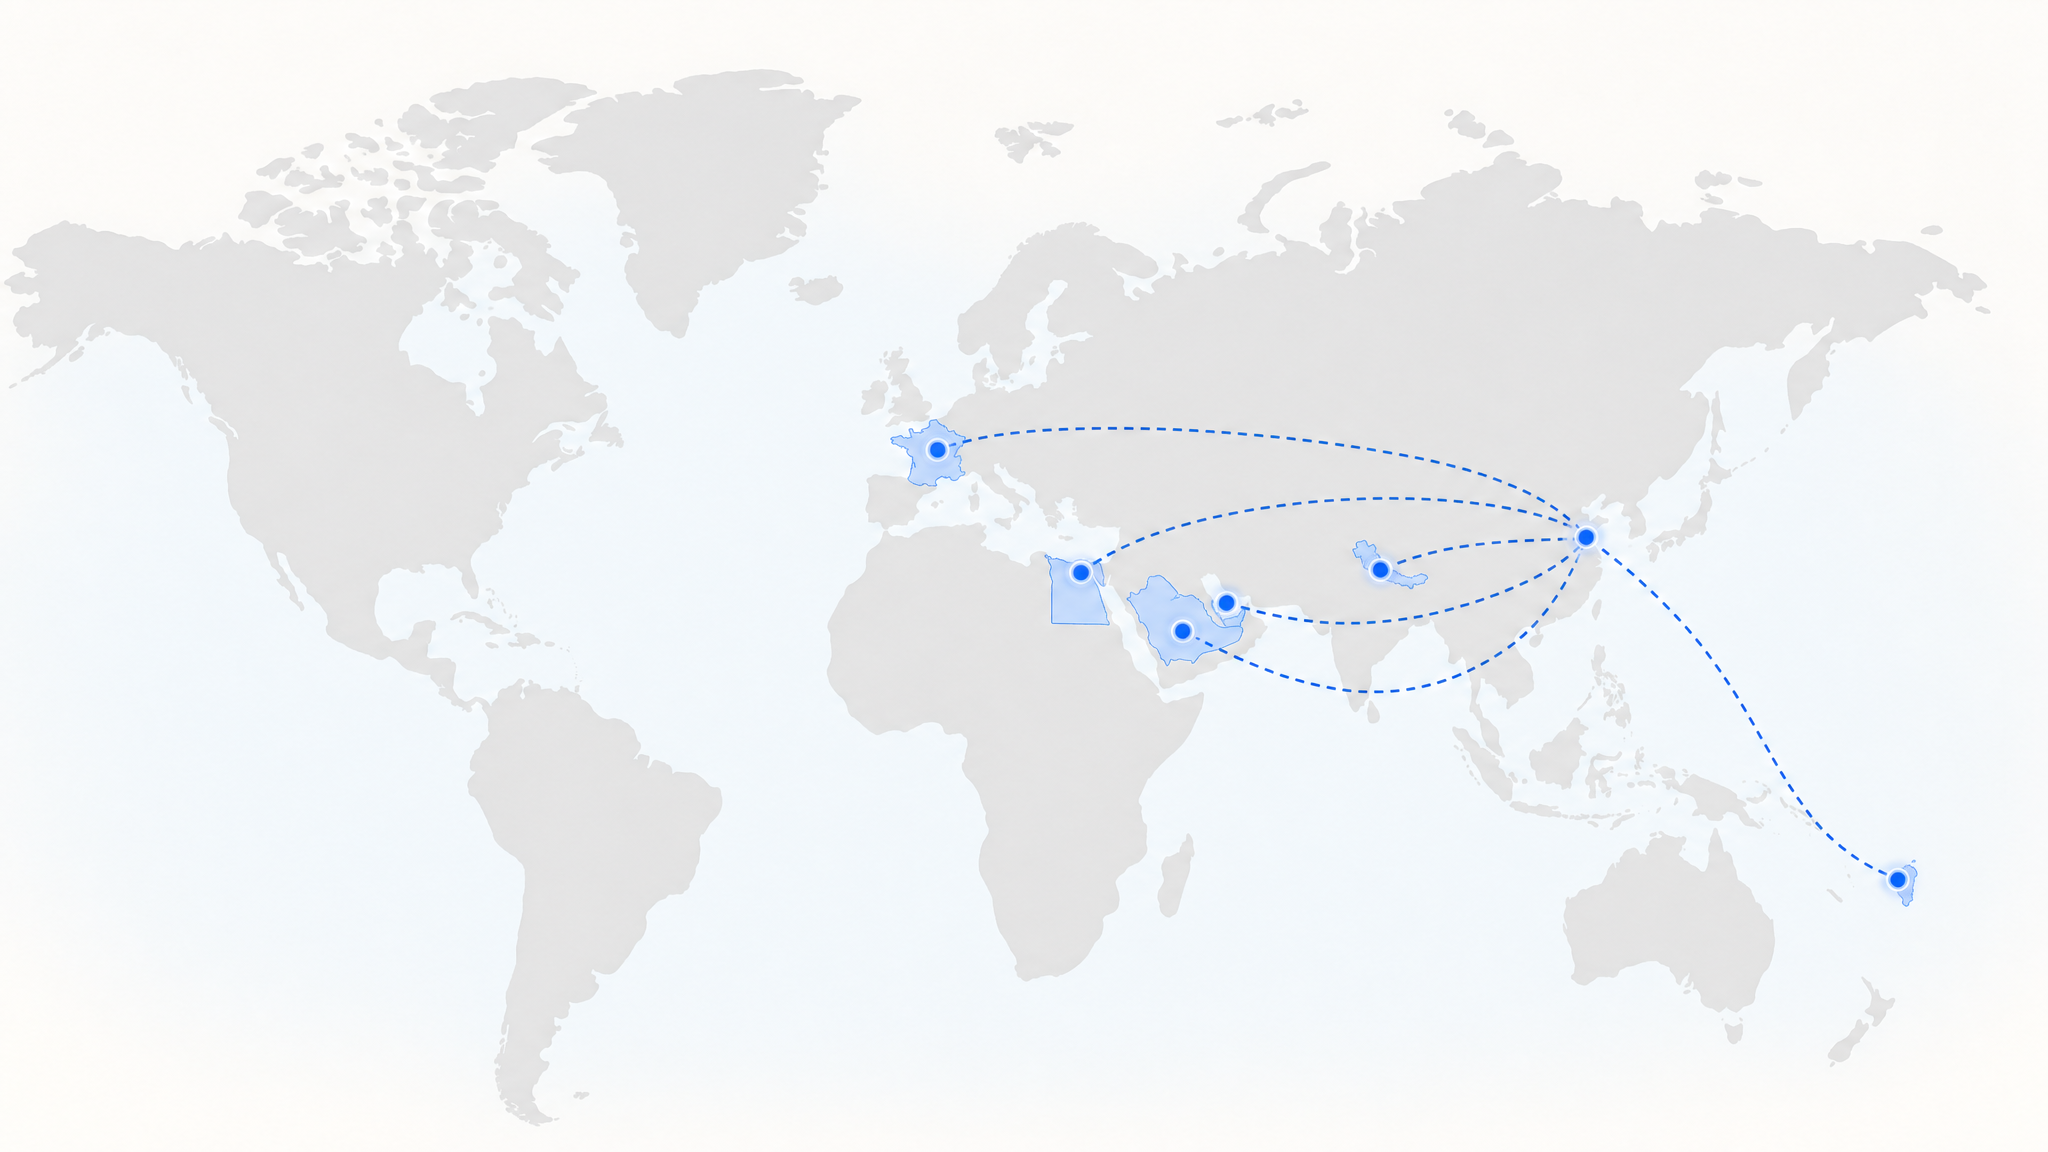
Os data centers de AI da SOETECK são projetados para a logística global. Construídos em contêineres marítimos ISO padrão, viajam na infraestrutura de frete existente — navios contêiner, carretas e aeronaves de carga. Cada unidade passa por testes de aceitação em fábrica (FAT) completos antes de deixar nossa planta. Quando chega ao seu site, está pronta para o comissionamento — não para a montagem.
Data center contenedorizado personalizado para operação estável 24/7 no clima do Oriente Médio.
Leia o caso de sucesso →Auditoria de fábrica e grande projeto de infraestrutura digital para a modernização de data centers do governo.
Leia o caso de sucesso →Solução de data center contenedorizado de OLT móvel que viabiliza rápida implantação de infraestrutura 5G.
Leia o caso de sucesso →Otimização da infraestrutura de refrigeração de data center com ganhos de eficiência e confiabilidade.
Leia o caso de sucesso →Nossos contêineres com refrigeração líquida direto ao chip suportam até 120 kW por rack. Módulos de imersão suportam 100+ kW por rack sem derating. Configurações refrigeradas a ar estão disponíveis até 25 kW por rack para cargas de trabalho mais leves.
Nossa infraestrutura é agnóstica de GPU por design. Suportamos NVIDIA H100, H200, B200 (NVL72), AMD MI300X, Huawei Ascend 910B/C e Intel Gaudi 3. Power shelves e kits de montagem de cold plates são personalizados para a plataforma de GPU escolhida.
90–120 dias do pedido ao comissionamento para configurações padrão de até 5 MW. Configurações personalizadas e implantações hiperscale AI-Flex podem levar de 120 a 180 dias. Em comparação, a construção tradicional de data centers leva de 24 a 36 meses.
Aplicamos uma abordagem de defesa em profundidade: (1) loops de refrigerante com pressão negativa (o fluido retorna ao sistema em caso de qualquer rompimento); (2) cabos de detecção de vazamento tipo corda ao longo de todas as tubulações; (3) bandejas de gotejamento de aço inoxidável sob todas as conexões; (4) sensores de condutividade monitorados 24/7 com válvulas de fechamento automático; (5) refrigerante PG25 de propilenoglicol não condutivo que não danifica a eletrônica em caso de contato.
Refrigeração líquida direto ao chip: PUE de 1.08–1.15 dependendo do clima. Refrigeração por imersão: PUE tão baixo quanto 1.03. Ambos os valores assumem free cooling com dry coolers onde o clima permite.
Sim. Nossos contêineres são especificados para temperaturas ambientes de -40°C a +55°C (+131°F). Já implantamos com sucesso em ambientes desérticos do Oriente Médio (Arábia Saudita, Catar, Egito) e em condições de ilhas tropicais (Vanuatu). Cada implantação inclui configurações de refrigeração específicas para o clima.
Sim. Nossa equipe global de comissionamento viaja até o seu site para supervisão de instalação, partida do sistema, testes de aceitação e treinamento de operadores. Também oferecemos contratos anuais de manutenção opcionais com monitoramento remoto (NOC 24/7), visitas preventivas de manutenção e SLAs de resposta a emergências.
Fale com um Engenheiro
Informe o tipo de instalação, carga e região. Nossa equipe ajudará a identificar a configuração ideal.