

2–3 años de construcción
Los centros de datos tradicionales requieren de 24 a 36 meses desde la planificación hasta la puesta en servicio. Cuando la instalación está lista, su arquitectura de GPU ya está una generación atrás.

El desafío
La revolución de las GPUs superó el diseño tradicional de los centros de datos. Las GPU H100 y B200 exigen densidades de potencia que rompen los límites de la refrigeración convencional — y plazos de construcción que no siguen el ritmo de la innovación en AI.
2–3 años de construcción
Los centros de datos tradicionales requieren de 24 a 36 meses desde la planificación hasta la puesta en servicio. Cuando la instalación está lista, su arquitectura de GPU ya está una generación atrás.
25 kW — el límite del aire
Por encima de 25kW por rack, la refrigeración por aire forzado simplemente no extrae el calor con suficiente rapidez. Los clústeres NVIDIA H100 superan habitualmente los 40kW — y el B200 rebasa los 100kW. La refrigeración por aire ya no es una opción.
$50M+ de capital antes de la primera GPU
La construcción convencional exige un capital inicial masivo — adquisición del terreno, permisos, obra civil, infraestructura MEP — todo antes de instalar un solo servidor. Esto retrasa el ROI e inmoviliza capital durante años.
La plataforma
Una plataforma integrada que entrega el centro de datos de AI completo — térmica, energía, estructura y control — diseñada a medida para su carga de trabajo de GPU.
Cada centro de datos de AI de SOETECK se fabrica en planta dentro de contenedores marítimos ISO estándar. 95% preensamblado, probado en nuestra fábrica y enviado a todo el mundo. Conecte energía, red y agua — la computación comienza.
La tecnología de cold plates de contacto directo con el chip extrae el calor en la fuente. Unidades de Distribución de Refrigerante (CDU) integradas que gestionan hasta 1.5MW de carga térmica por módulo. PUE tan bajo como 1.08.
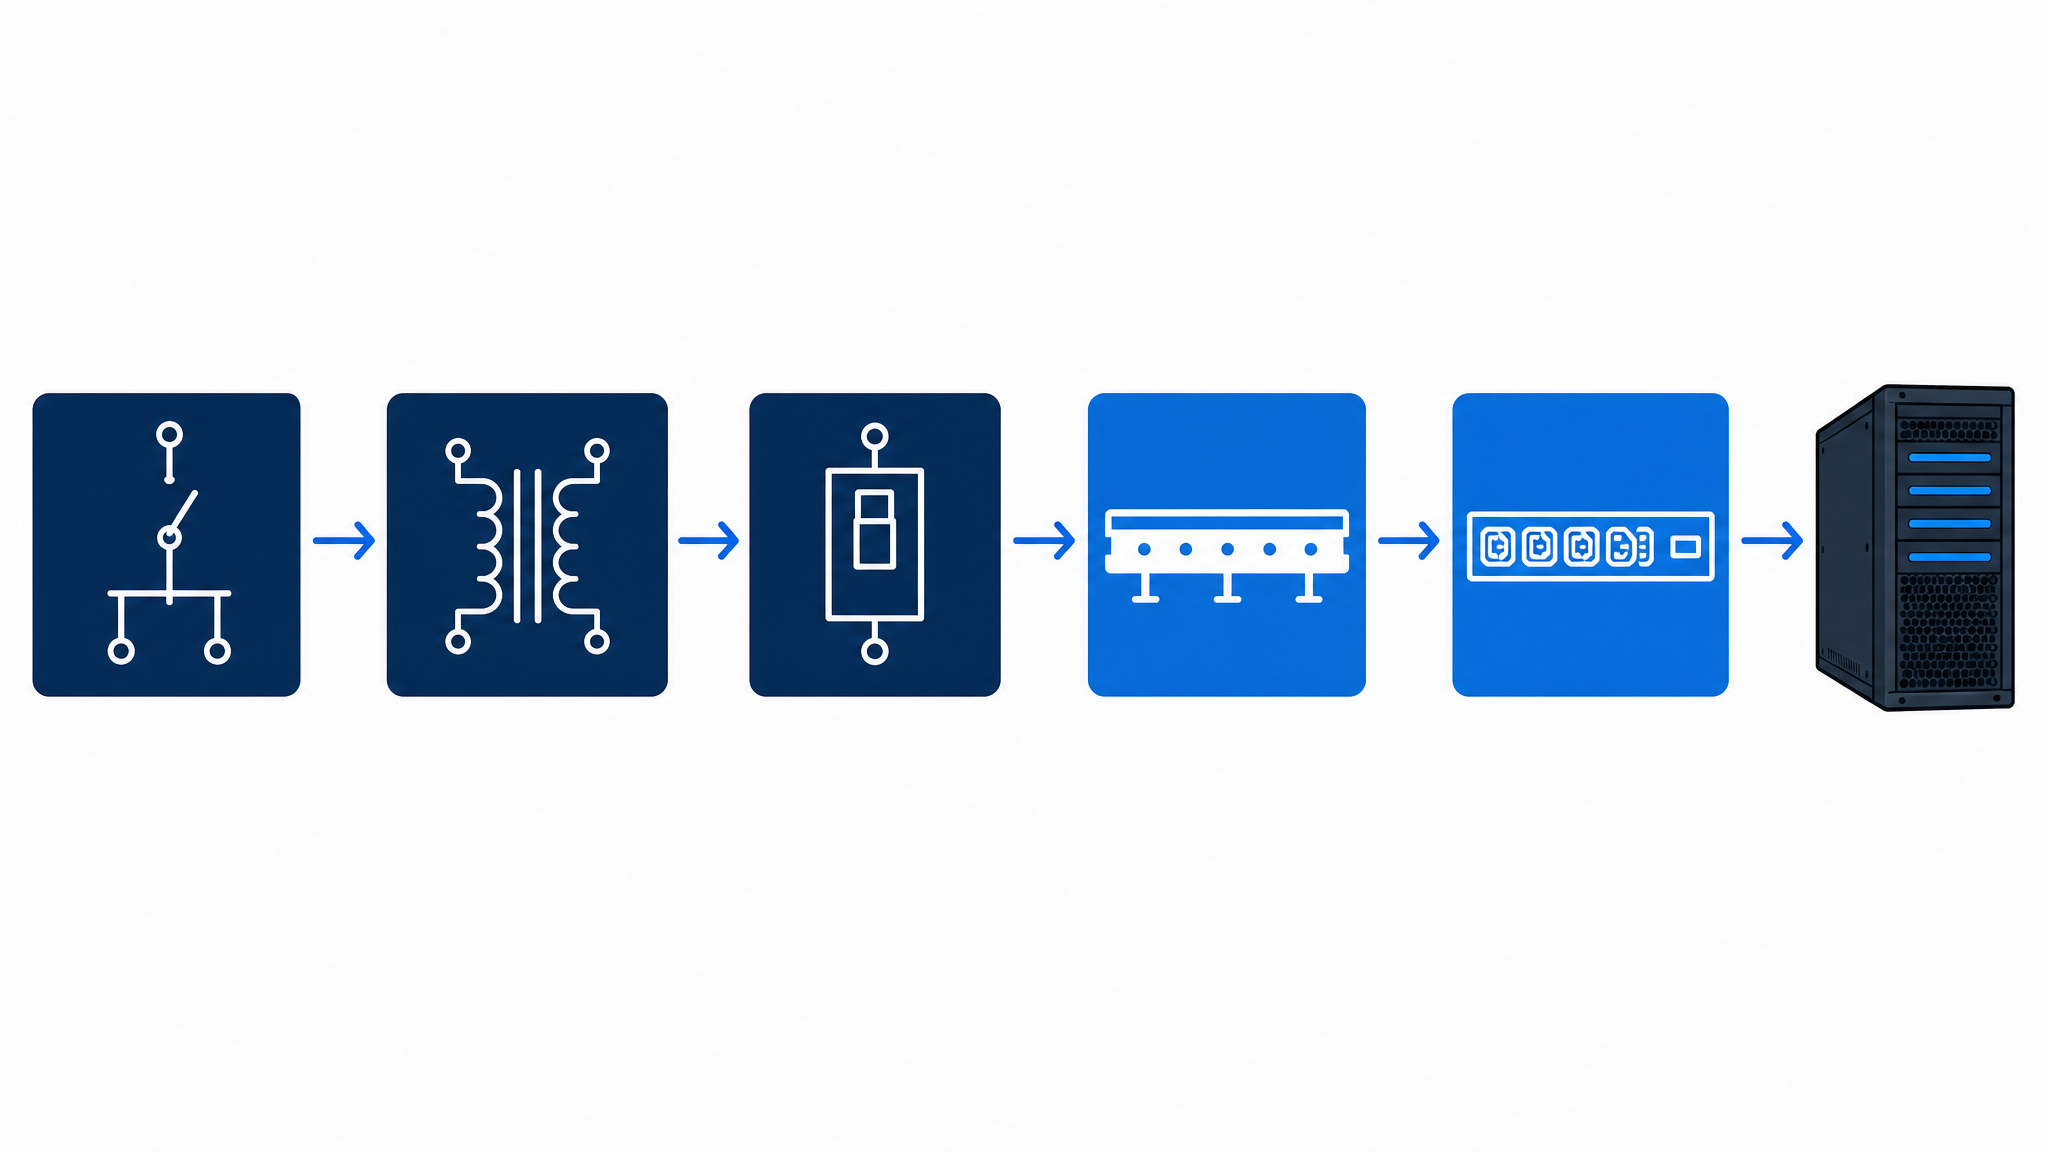
Desde tableros de media tensión hasta PDU de rack inteligentes — diseñado para 40–120kW por rack. UPS modulares de iones de litio, canalización de 800A, medición por tomacorriente.
Sin dependencia de un solo fabricante. Soporte total para NVIDIA H100/H200/B200, AMD MI300X, Huawei Ascend 910B/C e Intel Gaudi. Elija la GPU que se ajuste a su carga de trabajo y presupuesto.
Una sola plataforma de infraestructura de AI que escala desde la inferencia en el borde hasta clústeres hiperscale.
| Especificación | AI-Edge | AI-Core | AI-Flex |
|---|---|---|---|
| Contenedor | Contenedor estándar ISO de 20ft | Contenedor estándar ISO High-Cube de 40ft | 4–20+ módulos de 40ft interconectados |
| Potencia | 80–200 kW | 300–600 kW | 2–20 MW |
| Capacidad de GPU | 8–16 GPU | 32–64 GPU | 256–2048+ GPU |
| Refrigeración | Refrigerado por aire estándar, líquido opcional | Líquido de contacto directo con CDU integrado | Líquido centralizado + inmersión opcional |
| Densidad por rack | Hasta 30 kW | Hasta 100 kW | Hasta 120 kW |
| PUE | 1.15–1.25 | 1.08–1.15 | < 1.10 (1.03 inmersión) |
| Despliegue | 60–90 días | 90–120 días | 120–180 días |
| Ideal para | Inferencia en el borde, manufactura inteligente, edge 5G | Entrenamiento de LLM, fine-tuning, clústeres de investigación | AI hiperscale, nubes de AI, cómputo nacional |
Inferencia en el borde
Ideal para: Inferencia de AI en el borde, manufactura inteligente, edge 5G de telecom, AI en retail
Consultar por AI-Edge →Entrenamiento y fine-tuning
Ideal para: Entrenamiento de LLM empresarial, fine-tuning de modelos de AI, clústeres de investigación universitaria
Consultar por AI-Core →Clústeres hiperscale
Ideal para: Entrenamiento de AI hiperscale, proveedores de nube de AI, centros nacionales de cómputo de AI
Consultar por AI-Flex →Refrigeración
La física es simple: los refrigerantes líquidos ofrecen más de 3000× la capacidad de extracción de calor por unidad de volumen que el aire. Todos los hyperscalers están migrando a la refrigeración líquida. La única pregunta es a qué velocidad.
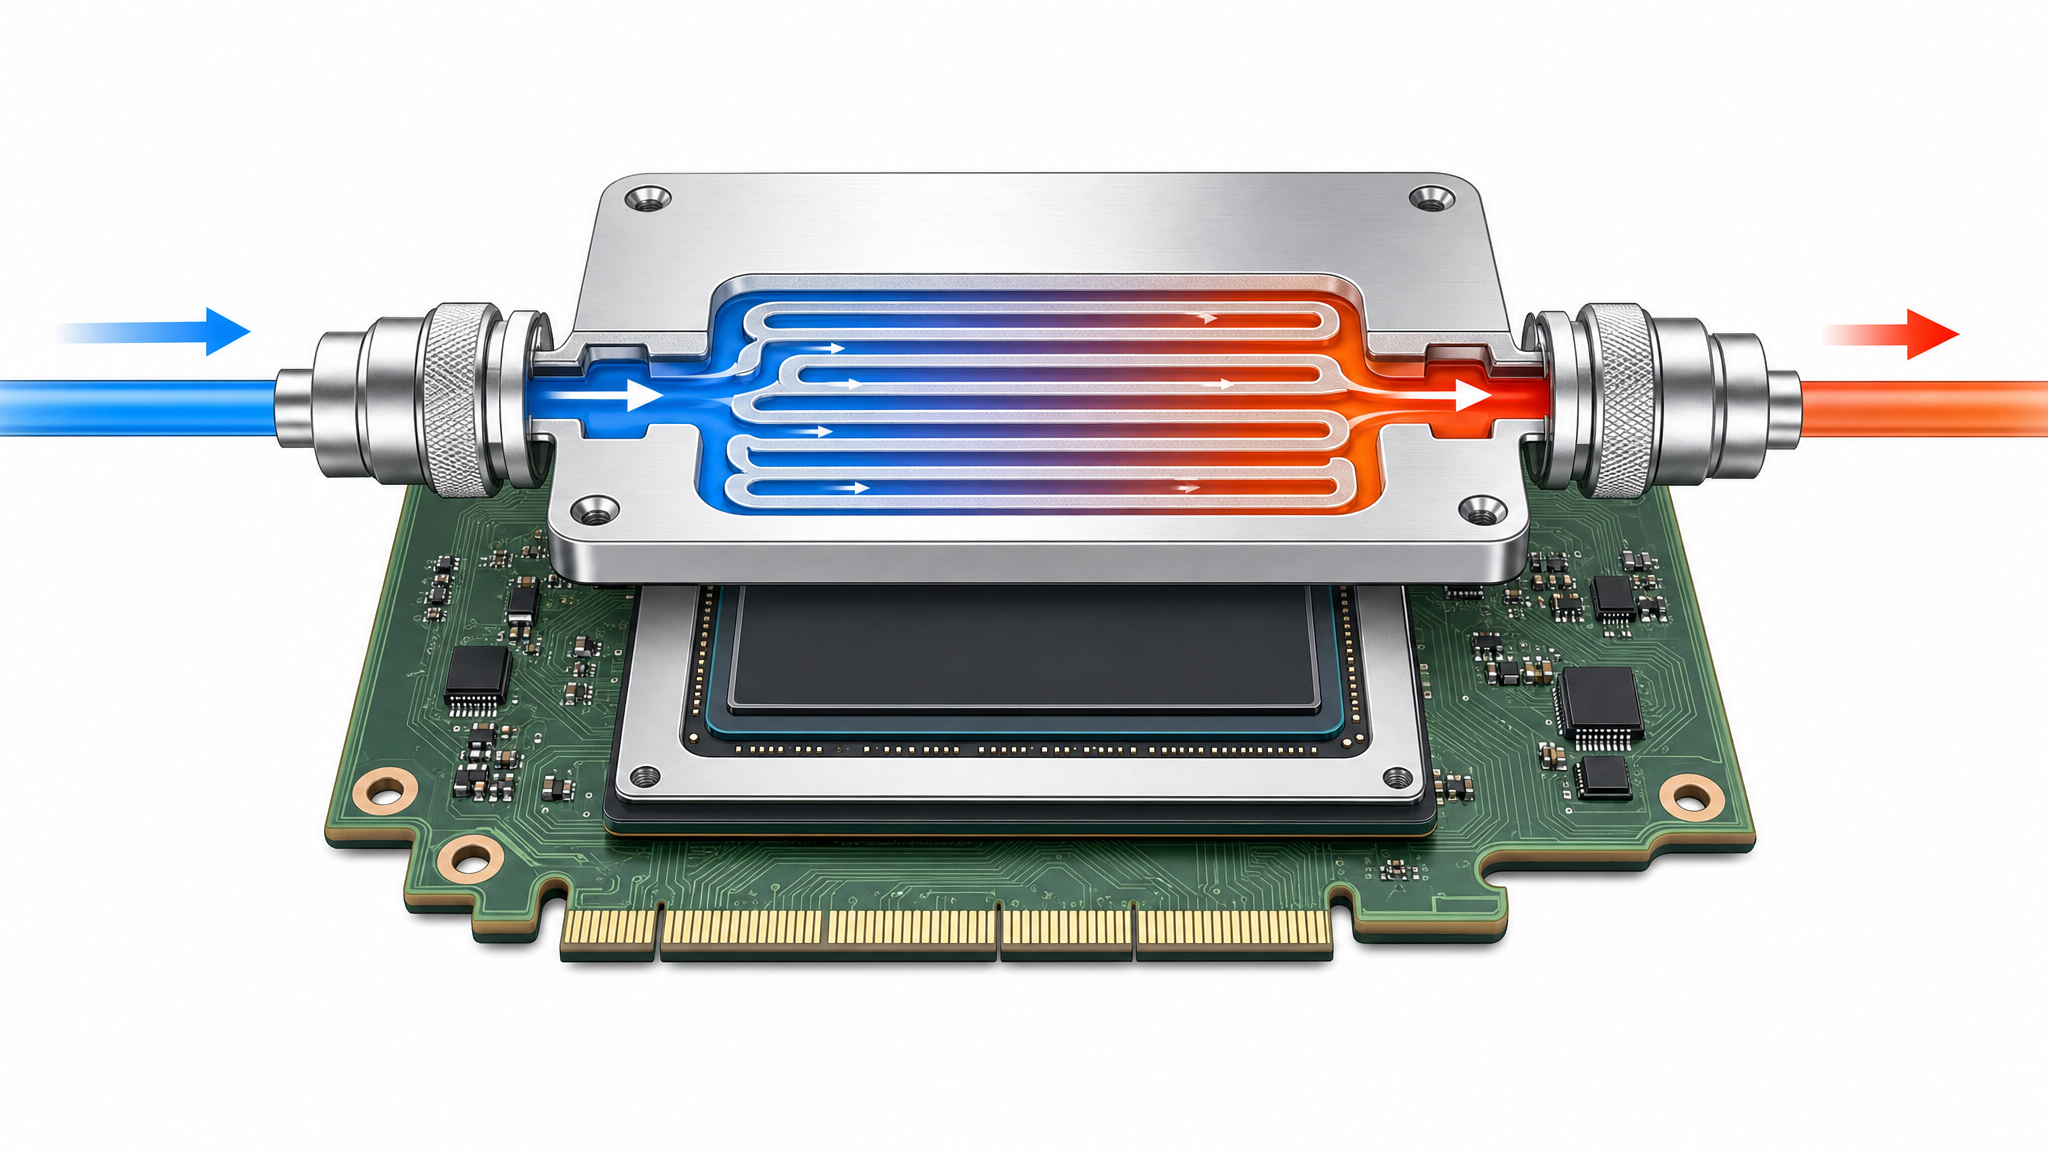
La refrigeración líquida de contacto directo con el chip es el caballo de batalla de la infraestructura de AI moderna. Las cold plates se montan directamente sobre los heat spreaders de las GPU y CPU, haciendo circular un refrigerante dieléctrico por aletas de microcanales para extraer el calor en la fuente.
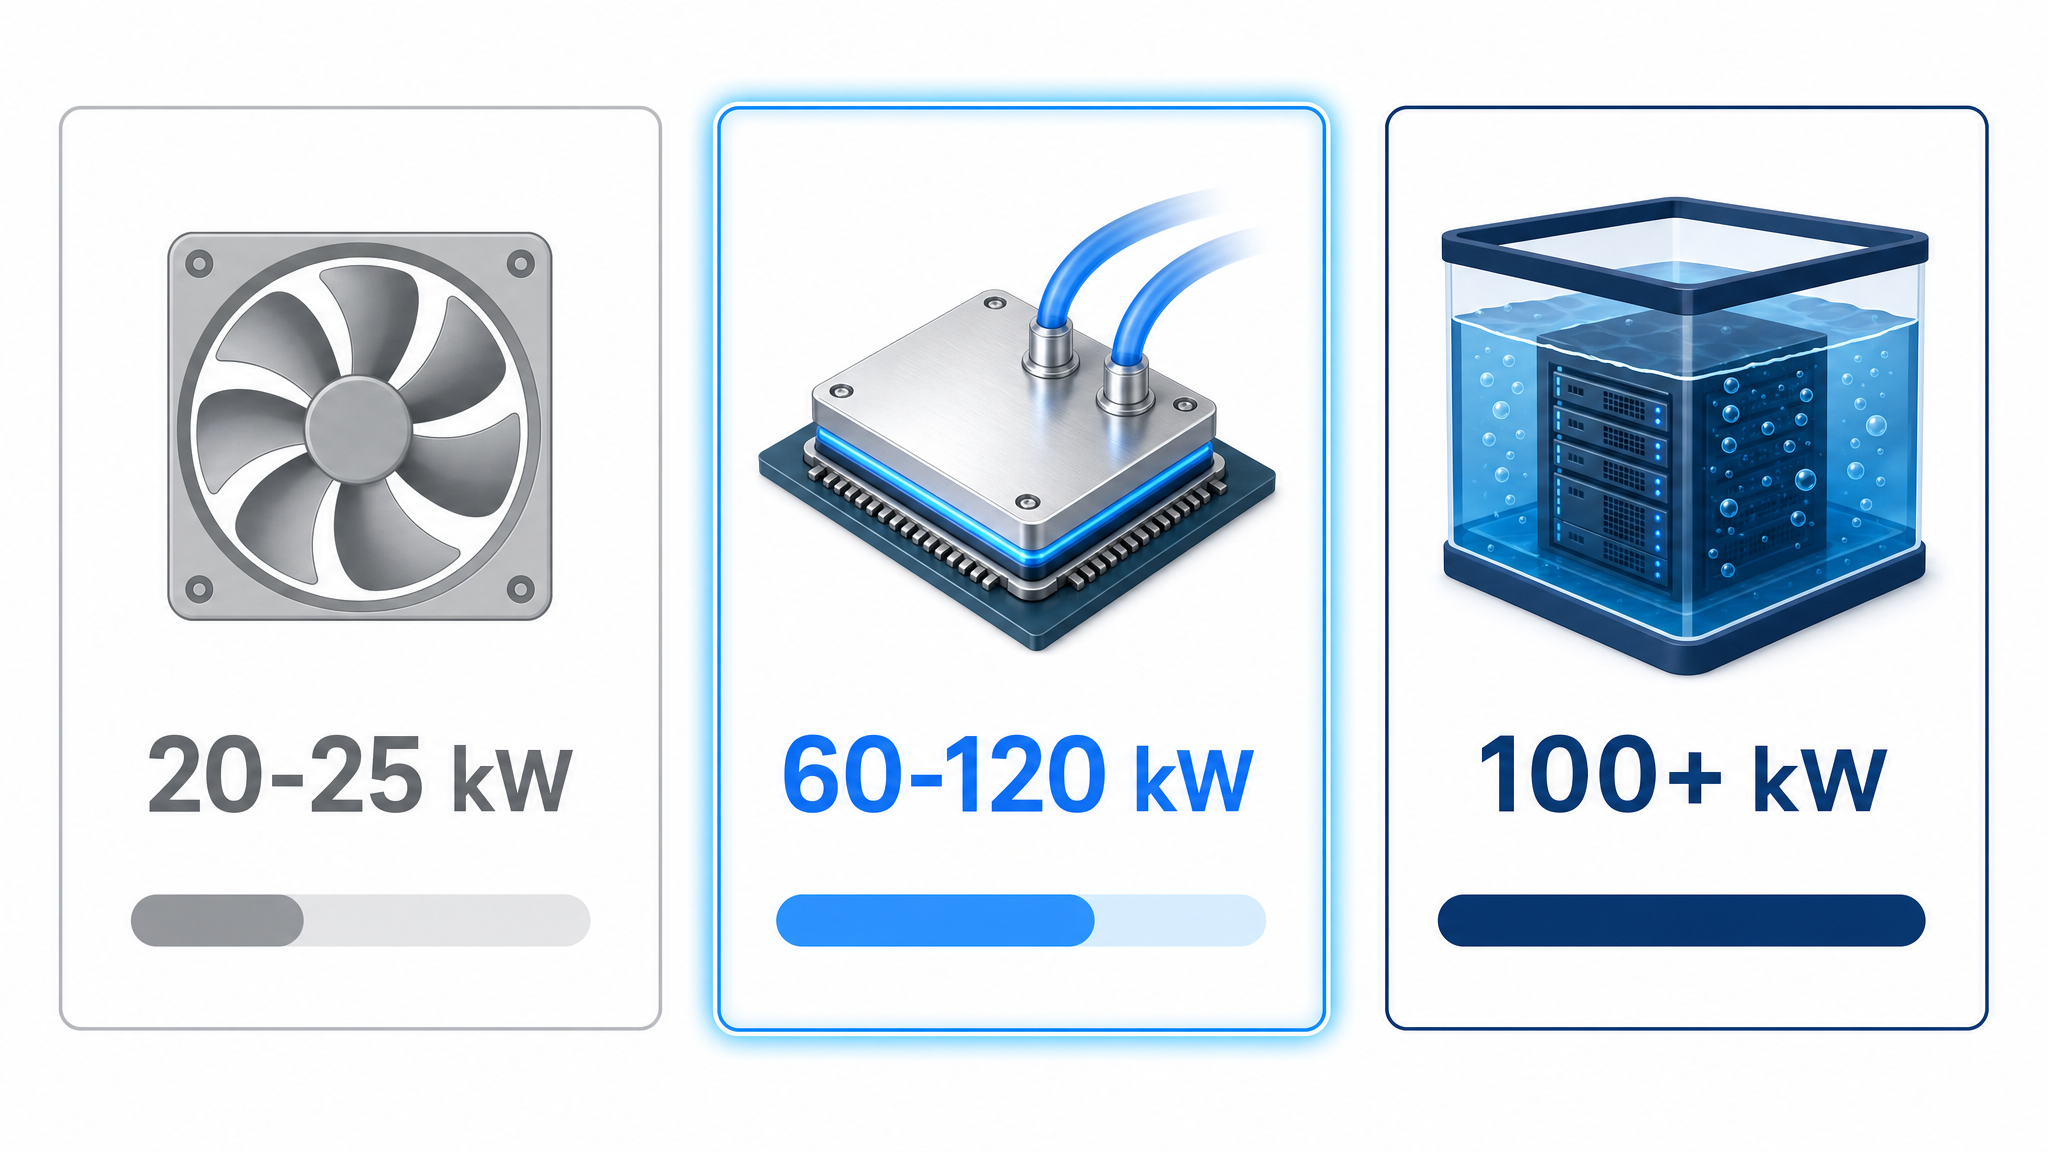
Para los despliegues de mayor densidad, la refrigeración por inmersión monofásica sumerge servidores de GPU completos en un fluido dieléctrico que absorbe el calor 1200× más eficientemente que el aire.
El aire tiene una capacidad calorífica volumétrica de ~1.2 kJ/m³·K. Los refrigerantes líquidos ofrecen 3500–4200 kJ/m³·K — más de 3000× la capacidad de extracción de calor por unidad de volumen.
Energía
Los clústeres de GPU no solo necesitan más energía — la necesitan entregada de otra manera. Nuestra cadena integrada de distribución eléctrica está diseñada desde cero para cargas de trabajo de AI de alta densidad y misión crítica.
Tecnología de baterías de iones de litio, redundancia N+1 o 2N, eficiencia del 98% en modo eco. Escalable de 100kW a 2MW por módulo. Módulos de batería con conexión en caliente y Sistema de Gestión de Baterías (BMS) integrado.
Canalización aérea de 160A–800A con cajas de derivación cada 600mm. Elimina la complejidad del cableado bajo piso. Las derivaciones con conexión en caliente permiten agregar o reubicar racks de GPU sin apagones.
Medición eléctrica por tomacorriente (precisión de ±1%), conmutación remota de tomacorrientes, sensores ambientales integrados (temperatura, humedad, contacto de puerta). SNMP v3 + REST API para integración con plataformas DCIM y BMS.
Velocidad hacia el cómputo
Del pedido a las GPUs operativas en 90–120 días, frente a los 24–36 meses de una construcción tradicional.
Requisitos confirmados. Selección de GPU finalizada. Diseño eléctrico aprobado.
Contenedor fabricado. CDU de refrigeración integrado. Sistema completo probado en nuestra fábrica.
Logística gestionada del puerto al sitio. El despacho de aduana queda a cargo de nuestros socios globales de flete.
Conecte energía, red y agua. Pruebas de aceptación. Capacitación de operadores. El cómputo comienza.
Logística global
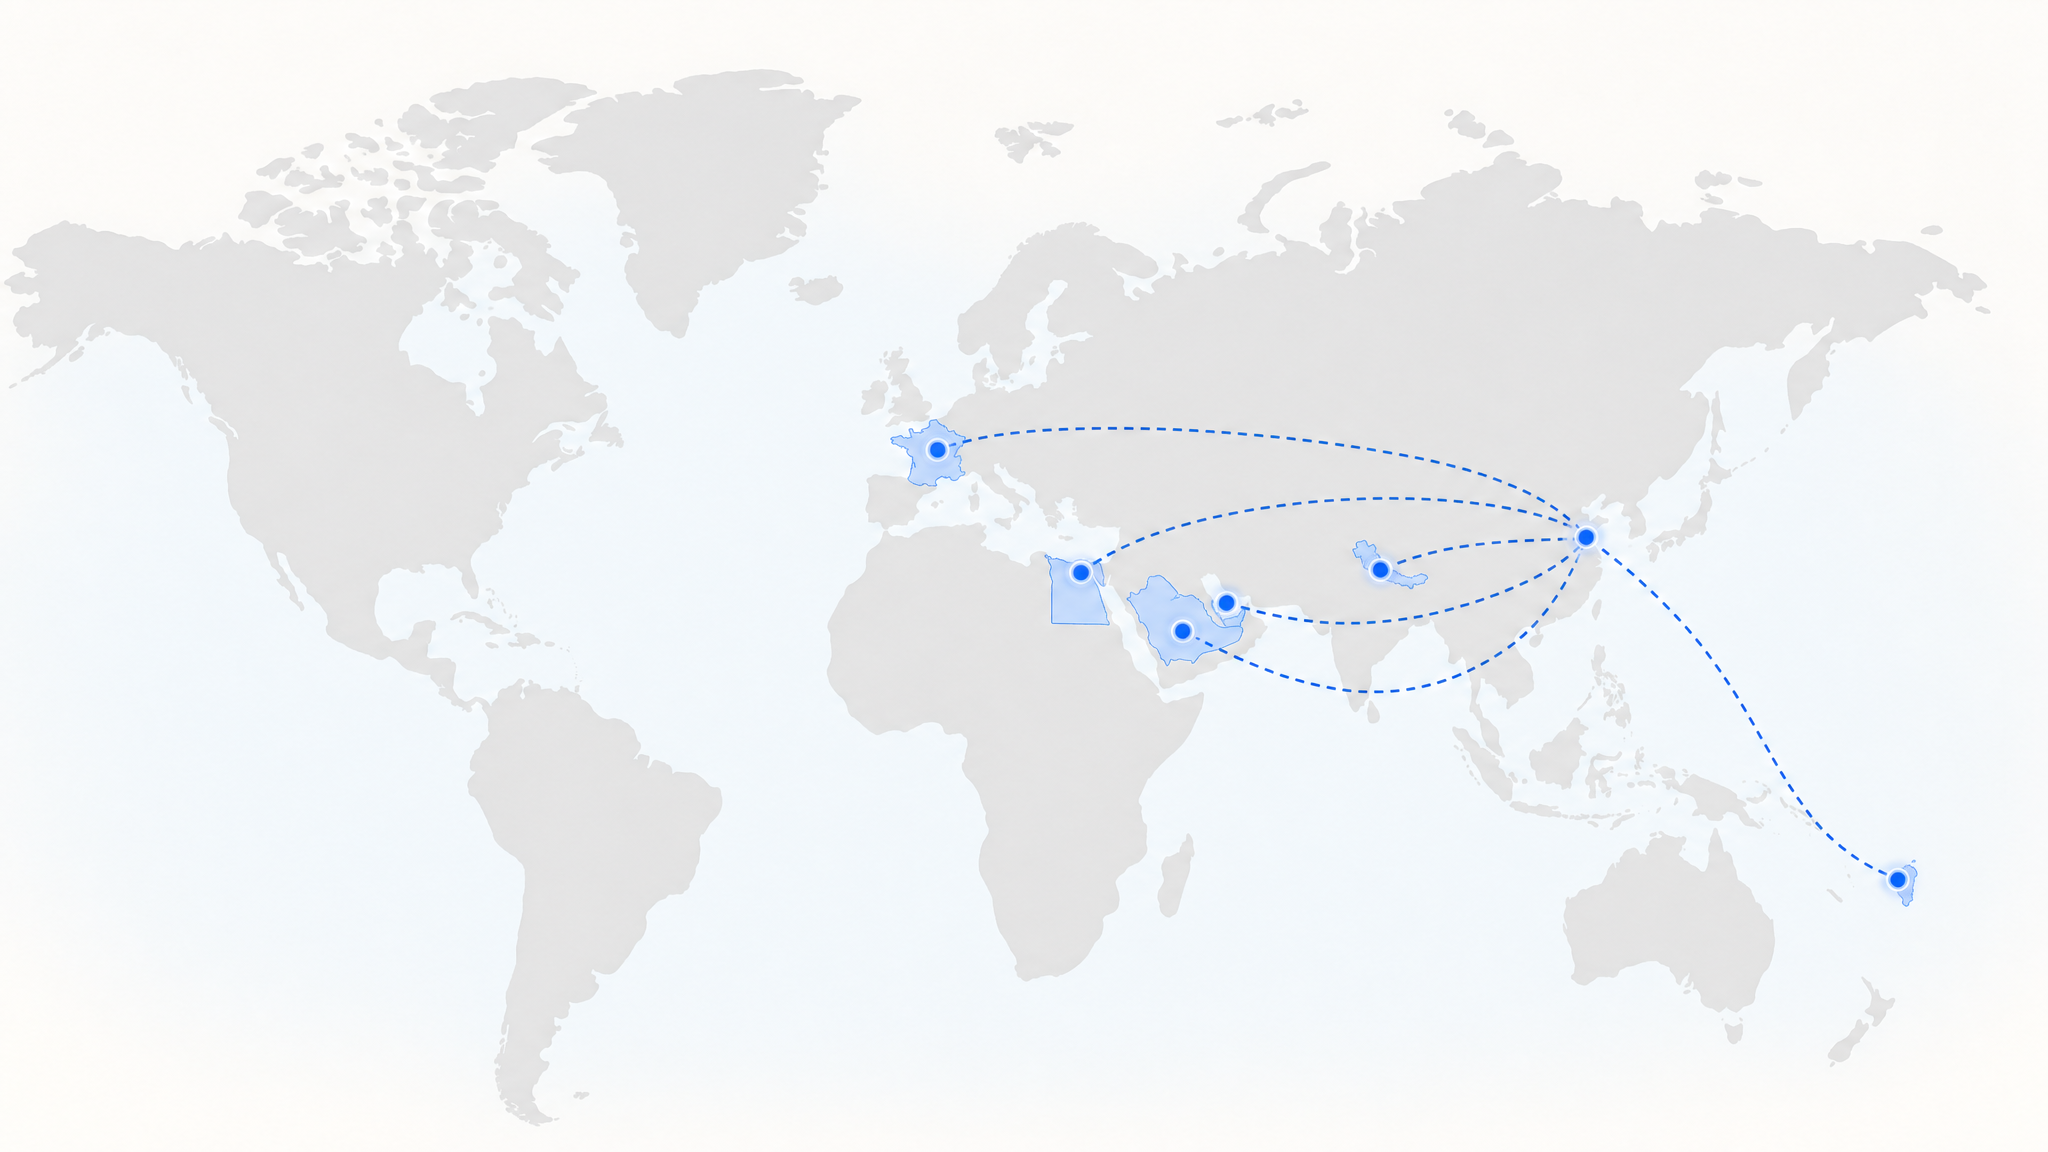
Los centros de datos de AI de SOETECK están diseñados a medida para la logística global. Integrados en contenedores marítimos ISO estándar, viajan sobre la infraestructura de carga existente — buques portacontenedores, camiones plataforma y aviones de carga. Cada unidad pasa por pruebas de aceptación en fábrica (FAT) completas antes de salir de nuestra planta. Cuando llega a su sitio, está lista para la puesta en marcha — no para el ensamblaje.
Centro de datos contenedorizado a medida para operación estable 24/7 en el clima de Medio Oriente.
Lea el caso de éxito →Auditoría de fábrica y gran proyecto de infraestructura digital para la modernización de centros de datos gubernamentales.
Lea el caso de éxito →Solución de centro de datos contenedorizado de OLT móvil que permite un despliegue rápido de la infraestructura 5G.
Lea el caso de éxito →Optimización de la infraestructura de refrigeración del centro de datos, con mayor eficiencia y confiabilidad.
Lea el caso de éxito →Nuestros contenedores con refrigeración líquida de contacto directo con el chip admiten hasta 120 kW por rack. Los módulos de inmersión admiten 100+ kW por rack sin derating. Las configuraciones refrigeradas por aire están disponibles hasta 25 kW por rack para cargas de trabajo más ligeras.
Nuestra infraestructura es agnóstica de GPU por diseño. Soportamos NVIDIA H100, H200, B200 (NVL72), AMD MI300X, Huawei Ascend 910B/C e Intel Gaudi 3. Las power shelves y los kits de montaje de cold plates se personalizan según la plataforma de GPU elegida.
90–120 días desde el pedido hasta la puesta en marcha para configuraciones estándar de hasta 5 MW. Las configuraciones a medida y los despliegues hiperscale AI-Flex pueden llevar de 120 a 180 días. En comparación, la construcción tradicional de centros de datos lleva de 24 a 36 meses.
Aplicamos un enfoque de defensa en profundidad: (1) lazos de refrigerante con presión negativa (ante cualquier fuga, el fluido retorna al sistema); (2) cables de detección de fugas tipo soga a lo largo de todas las tuberías; (3) bandejas de goteo de acero inoxidable bajo todas las conexiones; (4) sensores de conductividad monitoreados 24/7 con válvulas de cierre automático; (5) refrigerante PG25 de propilenglicol no conductivo que no daña la electrónica en caso de contacto.
Refrigeración líquida de contacto directo con el chip: PUE de 1.08–1.15 según el clima. Refrigeración por inmersión: PUE tan bajo como 1.03. Ambos valores asumen refrigeración libre (free cooling) con enfriadores secos (dry coolers) donde el clima lo permite.
Sí. Nuestros contenedores están especificados para temperaturas ambientales de -40°C a +55°C (+131°F). Hemos desplegado con éxito en ambientes desérticos de Medio Oriente (Arabia Saudita, Catar, Egipto) y en condiciones de islas tropicales (Vanuatu). Cada despliegue incluye configuraciones de refrigeración específicas para el clima.
Sí. Nuestro equipo global de puesta en marcha viaja a su sitio para supervisión de la instalación, arranque del sistema, pruebas de aceptación y capacitación de operadores. También ofrecemos contratos anuales de mantenimiento opcionales con monitoreo remoto (NOC 24/7), visitas de mantenimiento preventivo y SLA de respuesta ante emergencias.
Hable con un Ingeniero
Informe el tipo de instalación, carga y región. Nuestro equipo ayudará a identificar la configuración ideal.